
vLLM徹底解説:分散推論、KVキャッシュの進化、モデル圧縮
東京vLLMコミュニティナイト:分散推論・KVキャッシュ・モデル圧縮・本番運用を深掘りする5本のトーク。
- 日時
- 場所
- Minato City, Tokyo·対面
- 地域
- 関東(東京)
- 主催者
- Tokyo AI
- 言語
- EN
- 出典
- Luma
Tokyo AIの次のイベント
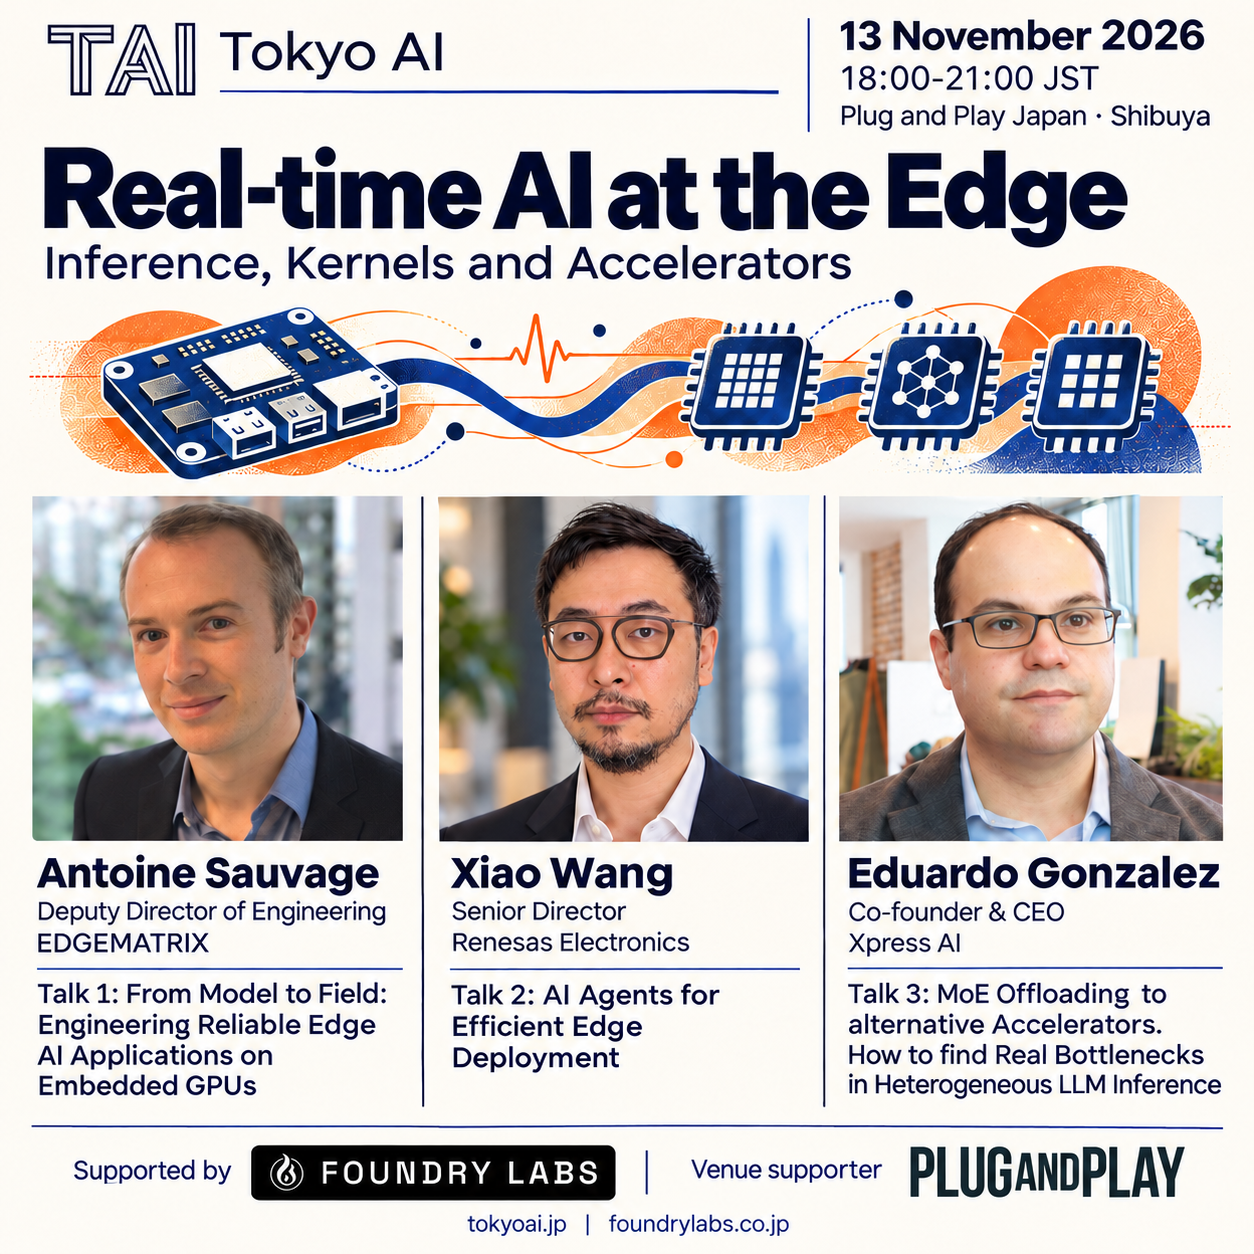
近日開催の関連イベント
Tokyo Python: 80のDAGで世界一周
Jarek Potiuk氏が、AI由来のPRや報告に対応するOSSメンテナー向けエージェントスキル集Apache Magpieを紹介。Airflow入門も。
対面 関東(東京) EN

独自のLLMを訓練する方法 🧑💻 & ネットワーキング 🤝
渋谷で、独自の軽量LLMをファインチューニングと圧縮でオフライン動作させる方法を学ぶ講演とライブデモ、その後ネットワーキング。
対面 関東(東京) EN

テックブランチ交流会
飯田橋のホテルで開くブランチ形式のミートアップ。オープンソースの経験、プロジェクト、ライセンスなどを語り合う。
対面 関東(東京) EN

概要
vLLM Community Night — Tokyoは、vLLMのコアコントリビューターと本番運用エンジニアが集まり、高スループット・低レイテンシのLLM推論について深く議論する技術夜会です。会場は六本木一丁目。vLLMの最新アップデート、分散コンポーネントへと進化するKVキャッシュ、富士通のOneCompによる実践的なモデル圧縮、AWS上での分散推論(SageMaker HyperPod、ParallelCluster、EFA/SRDネットワーキング、Prefill-Decode Disaggregation)、そしてShisa.AIによる本番運用のポストモーテムなど、5本のトークを予定しています。
登壇者はTun Jian Tan氏(vLLMコミッター、Embedded LLM)、市川勇馬氏(富士通)、赤澤俊信氏(AWS)、Tony Valderrama氏(Momento)、Leonard Lin氏(Shisa.AI)。低レベルな最適化からシステムレベルのスケーリング、ベンチマーク・評価・ハードウェア別チューニングといった現場の知見までを幅広くカバーします。
軽食とネットワーキング付き。AI/MLエンジニア、LLM研究者、インフラ・プラットフォーム構築者、AIプロダクト関係者、OSSコントリビューターなど、LLMサービングの未来に関心を持つ方にお勧めです。
コミュニティについて
主催はIlya Kulyatin氏(Tokyo AI / Foundry Labs株式会社)とJiaqi Lim氏(Embedded LLM)。4,000名以上を擁する日本最大のAIコミュニティ Tokyo AI (TAI) と、vLLMの主要コントリビューターであり企業・政府向けGPU管理プラットフォームTokenVisorを提供するAIインフラ企業 Embedded LLM が共同で開催します。
#vllm#llm-inference#kv-cache#model-compression#distributed-inference#ai-infrastructure#tokyo-ai#open-source#aws#mlops